iMac 2017(Intel Mac)+ macOS SequoiaでComfyUIをGPU(MPS)駆動させ画像生成
【執念】iMac 2017(Intel Mac)+ macOS SequoiaでComfyUIをGPU(MPS)駆動させ画像生成に成功した全手順
公開日: 2026年6月
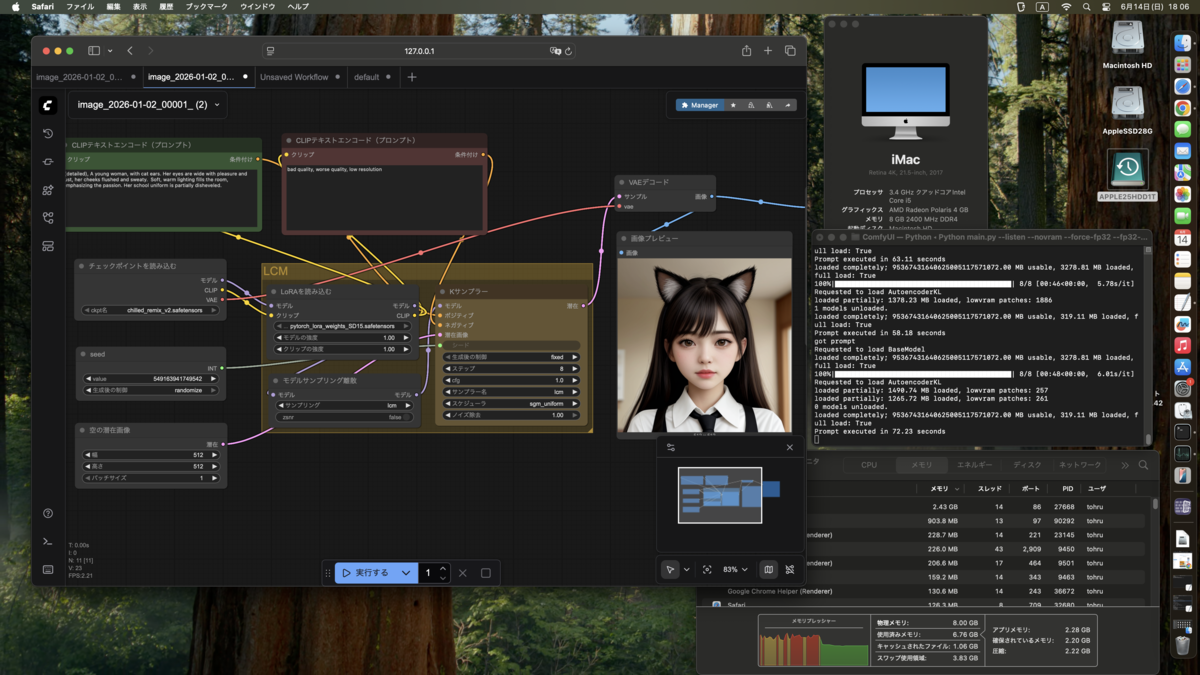
2026年現在、ローカル画像生成AI(ComfyUI)の動作環境はApple Silicon(Mシリーズ)が主流です。しかし、最新のmacOS Sequoia(macOS 15)をインストールした古いIntel Mac(iMac 2017など)でも、適切な設定を行えばMPS(Metal Performance Shaders)によるGPU加速を使って画像生成ができることが判明しました!
CPU駆動の絶望的な遅さから解放され、内蔵GPU(AMD Radeon等)を限界まで叩き出すための環境構築手順と、道中で必ず遭遇するエラーの回避策(ソースコードの書き換えパッチ)をブログにまとめました。
🛠️ ステップ1:必要なツールとPython 3.12の導入
まずはすべての土台となるツール類を導入します。互換性を最優先するため、Pythonは定番の「3.12」を使用します。Python環境がすでに構築済みであれば、この手順はスキップし、ステップ2から進めます。
1. Homebrewのインストール
ターミナルを開き、パッケージ管理ツール「Homebrew」を入れます(導入済みの場合はスキップ)。インストールコマンドは公式サイトを参照してください。インストール完了後、パスを通す作業を忘れずに。
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"2. Python 3.12、Git、wgetの一括導入
Python未インストールの場合、Mac全体(システム)で使うPython 3.12と、開発に必要なコマンドラインツールをHomebrewで入れます。(すでにPythonインストール済みの場合はスキップ)
brew install python@3.12 git wget3. パスを通す(環境の有効化)
前の手順でPythonをインストールした場合、HomebrewのPythonを優先的に使う設定を書き込みます。
echo 'export PATH="/usr/local/opt/python@3.12/bin:/usr/local/opt/python@3.12/libexec/bin:$PATH"' >> ~/.zshrc
source ~/.zshrc
4. 超高速Python管理ツール「uv」のインストール
ライブラリの爆速インストールと仮想環境構築のために、今回は「uv」を導入します。
curl -LsSf https://astral.sh/uv/install.sh | sh※完了後、設定を反映させるために一度ターミナルを完全に閉じて再起動してください。
🚀 ステップ2:ComfyUIのダウンロードと仮想環境の作成
次にComfyUI本体をダウンロードし、専用の隔離環境を構築します。
1. ComfyUIのクローンとフォルダ移動
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI
2. Python 3.12の仮想環境を作成・アクティベート
uv venv --python 3.12
source .venv/bin/activate
3. 依存ライブラリの一括インストール
uv pip install -r requirements.txt4. 【重要】NumPyの互換性エラー対策
最新のNumPy 2.x系が入ると互換性エラーでクラッシュするため、1.x系の最終安定版へ強制再インストール(ダウングレード)します。
uv pip install "numpy<2" --force-reinstall💡 起動チェックと「起動しない場合」の巻き戻し手順
まずは一度、以下のコマンドでCPUモードとして正常に立ち上がるかテストをします。
python main.py --cpu⚠️ 最新版ComfyUIの構造が原因でエラーが出る場合
最新のコード(PyTorch 2.4+前提の機能など)が古いIntel Mac向けの環境と衝突して動かない場合、Intel Macで最も安定動作する過去のバージョンまでComfyUIを巻き戻します。
# Gitの全履歴を取得して特定のバージョンにチェックアウト
git fetch --unshallow
git checkout v0.3.73

# 巻き戻したバージョン向けに依存関係を再調整
uv pip install -r requirements.txt

# 再度NumPy 1.x系を強制適用
uv pip install "numpy<2" --force-reinstall
🔥 本題:VRAMの少ないIntel Macで「MPS(GPUあり)」で動かす設定
iMac 2017などのIntel Macに搭載されているAMD製GPUは、ビデオメモリ(VRAM)が少なく、そのままではすぐにメモリ不足で落ちます。
これを回避し、macOSの「MPS」機能を極限までローカル最適化して起動する魔法のコマンドがこちらです。
# MPSのメモリ上限によるクラッシュを防ぐ環境変数を指定
export PYTORCH_MPS_HIGH_WATERMARK_RATIO=0.0

# VRAM消費を抑え、iMacのGPUで画像生成を実行するコマンド
python main.py --listen --novram --force-fp32 --fp32-vae
※ --novram でメインメモリへ賢くオフロードし、--force-fp32 でIntel環境の計算バグを防ぎます。
💥 遭遇したエラーと力技の対策パッチ
MPS起動時に以下のエラーを吐いてクラッシュした場合は、ComfyUIのソースコードを直接1箇所だけコメントアウトすることで力技で突破できます。
発生するエラー
AttributeError: module 'torch.compiler' has no attribute 'is_compiling'
🛠️ 対策手順(ソースコードの書き換え)
ComfyUIフォルダ内にある comfy/ops.py をテキストエディタ(VSCodeやメモ帳など)で開きます。該当する以下の行を見つけ、先頭に # をつけて無効化(コメントアウト)してください。
# 変更前
if torch.compiler.is_compiling():
    return

# 👇 以下のようにコメントアウトする
# if torch.compiler.is_compiling():
#     return
書き換えて保存した後、再度上記のMPS用起動コマンドを実行すると、エラーが消えて見事にブラウザ上でComfyUIのUIが立ち上がり、GPUを用いた画像生成が始まります!
📋 まとめ
2026年現在、見捨てられつつあるIntel Mac環境ですが、「SequoiaのOS環境 + uvによるPython 3.12管理 + 起動オプションの工夫 + エラー箇所の直接書き換え」を組み合わせることで、見事に内蔵グラフィック(MPS)での実用的な画像生成に成功しました。
同じように「古いiMacをまだ現役でAIに使いたい!」と奮闘している方の参考になれば幸いです。ぜひ試してみてください!
GoPro MAXの360度動画をストリートビューに投稿するための支援ツールを作成しました!
GoPro MAXで撮影した360度動画を Google Street View で見られるようにしたい!
面倒なことに、GoPro PlayerでエクスポートしたMP4にはGPS情報が入らない。.360ファイルを元に、GPXファイルを作成する手順が必要だが、ツールをコマンドで実行したりと難易度が高い。
また、時間をかけて Google Street View Studio にアップロードするが、「内部エラー」や「GPSの揺れや跳びによるエラー」に悩まされる。
GoPro Playerで書き出した動画はメタデータが書き換わってしまうことが多く、そのままでは高確率でエラーになります。そこで、これらの問題を解決する2つのツールを開発しました。
1. GoProGPSAnalyzer
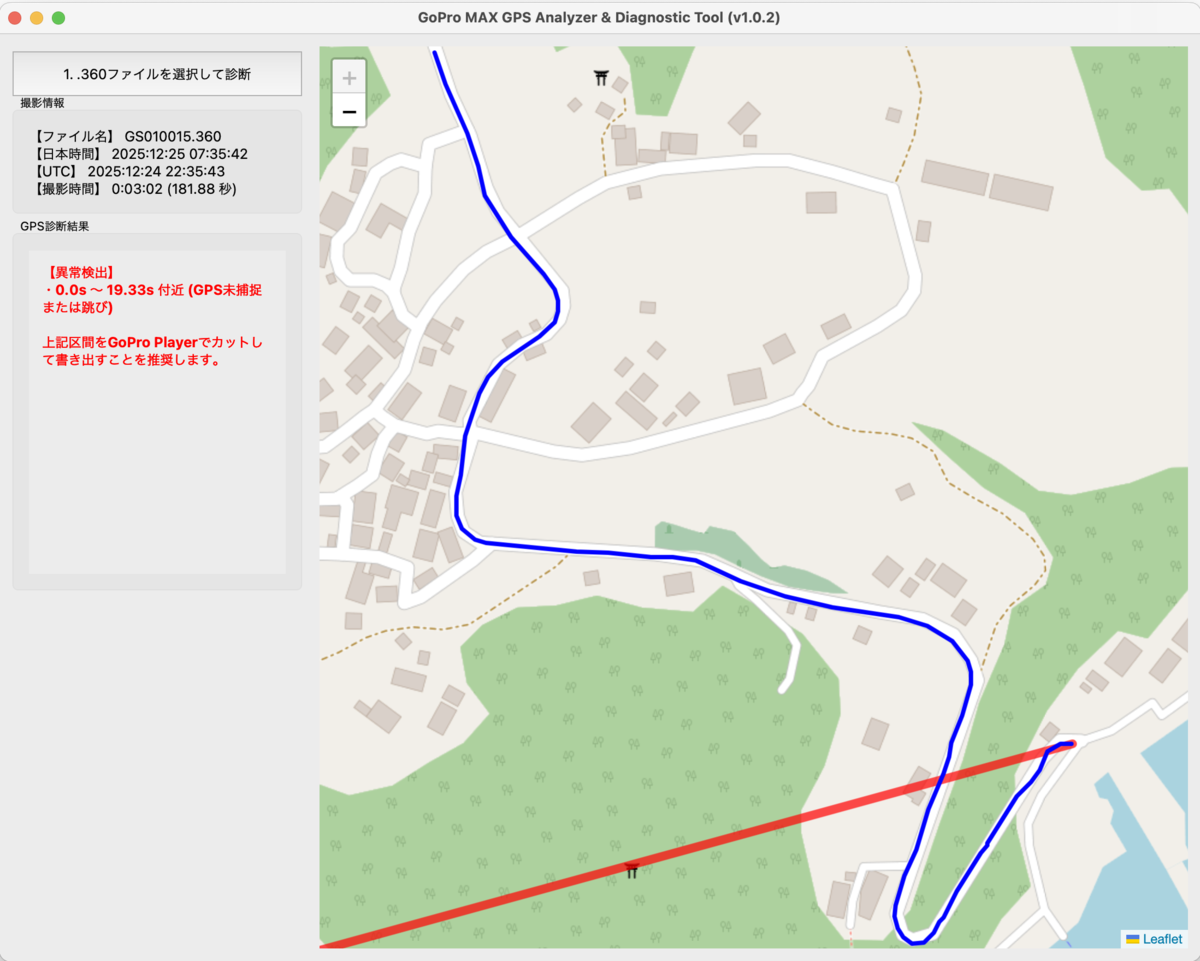
GoProGPSAnalyzer
書き出し・アップロードという長い時間を費やす前に、その動画が「受理されるかどうか」を事前に診断するツールです。
2. GoProStreetViewHelper

推奨ワークフロー
STEP 2: 編集
赤い区間がある場合、GoPro Playerで動画先頭からその秒数までをカットして.360保存、mp4エクスポート。
赤い区間がある場合、GoPro Playerで動画先頭からその秒数までをカットして.360保存、mp4エクスポート。
STEP 3: 修正・出力
Helperツールで書き出した
Helperツールで書き出した
mp4 を処理し、時刻修正済み動画とGPXを作成。ツールダウンロード:
動作環境OSに合った圧縮(zip)ファイルをダウンロード、展開後にアプリを実行します。
macOSの場合は、ダウンロード先の説明文を参照して隔離設定の解除を行なってください。
Releases · petarou-archive/gopro-streetview-helper · GitHub
2026年現在のmacOSとWindows 10/11の両方で動作確認済み。動作環境OSに合った圧縮(zip)ファイルをダウンロード、展開後にアプリを実行します。
macOSの場合は、ダウンロード先の説明文を参照して隔離設定の解除を行なってください。
Windows 10 で Wi-Fi と有線 LAN の両方を接続しつつ、デフォルトゲートウェイを有線 LAN に設定する簡単な方法
Windows 10 で Wi-Fi と有線 LAN の両方を接続しつつ、デフォルトゲートウェイを有線 LAN に設定する簡単な方法は、ネットワークインターフェースのメトリック値を調整すること です。
手順:
-
[ネットワーク接続] を開く
Win + Rを押してncpa.cplと入力し、Enter を押す。 -
有線 LAN(イーサネット)のプロパティを開く
-
「イーサネット」を右クリック → 「プロパティ」を選択。
-
-
IPv4 の設定を変更
-
「インターネット プロトコル バージョン 4(TCP/IPv4)」を選択し、「プロパティ」をクリック。
-
「詳細設定」を開く。
-
-
自動メトリックをオフにして手動設定
-
「自動メトリック」のチェックを外し、「インターフェイス メトリック」に 10 などの小さい値を入力。
-
-
Wi-Fi のメトリックを変更
-
設定を適用して再接続
-
すべてのウィンドウで「OK」を押して設定を保存し、ネットワークを再接続する。
-
効果:
-
優先度の低い Wi-Fi ではなく、有線 LAN をデフォルトゲートウェイとして使用。
この方法なら、簡単な設定変更で デフォルトゲートウェイを有線に固定 できます。
Macで動作するメッセージアプリ風AIチャットアプリを作りました!
Macローカルで動作する恋愛AIチャットアプリ
このガイドでは、Mac上で恋愛チャットアプリをローカルで実行する手順を紹介します。キャラクターとLINE風のチャットを楽しみながら、AIによるメッセージや自撮り写真のやり取りが可能です。


1. 必要な環境
本アプリを動作させるには、以下の環境が必要です。
2. 必要なツールのインストール
2.1 Python のインストール
Mac にはデフォルトで Python がインストールされていますが、python3 --version で確認し、3.9 以上でない場合は 公式サイト から最新バージョンをインストールしてください。
2.2 仮想環境の作成(推奨)
python3 -m venv chat_env
source chat_env/bin/activate
2.3 必要なPythonパッケージのインストール
pip install gradio diffusers torch ollama
3. Ollama のインストール
公式サイト Ollama からダウンロードし、インストールしてください。
その後、ollama run llama3:8b を実行して動作確認を行います。
4. Stable Diffusion の準備
お好みのSD1.5モデルファイルを使用できます。
sazyou-roukaku/chilled_remix at main 今回はこちらをお借りしました。
latent-consistency/lcm-lora-sdv1-5 at main LCM Loraダウンロード先
設置場所に合わせてchat_app.py中のモデルファイルパスを変更することを忘れずに。
5. アプリの構築
配置先:
/renaichat/
│── chat_app.py
│── generated_images/  # 画像ファイルを保存するフォルダ(自動作成)
5.1 バックエンド (chat_app.py)
次の内容で chat_app.py を作成します。
モデルファイルのパスは実行環境に合わせて変更してください。
import gradio as gr
import os
import time
import random
from datetime import datetime
import ollama
import torch
from diffusers import StableDiffusionPipeline, LCMScheduler

# キャラの好感度管理
character_affection = {
    "美咲": 0,
    "花音": 0,
    "涼夏": 0
}

# キャラ設定
character_settings = {
    "美咲": {"性格": "美人で優しい女性。面倒見が良く、癒し系。",
           "BIRTHDAY": "05-20",
           "PROMPT_CHAR": "a Japanese beauty woman, Light brown Long hair (wavey, glamorous style). ",
           "PROMPT_WEAR": "wearing a fitted white long sleeves ribbed top and a grey plaid suspenders overalls Dress. "},
    "花音": {"性格": "可愛くて明るいムードメーカー。元気いっぱいで好奇心旺盛。",
           "BIRTHDAY": "08-07",
           "PROMPT_CHAR": "a kawaii woman, loose curls twin tails Semi-long Hair. ",
           "PROMPT_WEAR": "wearing a white collared shirt, a red plaid pleated skirt, a plaid bow, a soft pink cardigan, knee-high white socks. "},
    "涼夏": {"性格": "クールでツンデレ。素直になれないが、時折見せる優しさが魅力。",
           "BIRTHDAY": "11-15",
           "PROMPT_CHAR": "a Japanese idol woman, Short bob Hair. ",
           "PROMPT_WEAR": "wearing a ivory long hoodie. "},
}

# メッセージ履歴
chat_history = []

# Stable Diffusionの準備
#diffusion_model = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5")
#diffusion_model.to("cuda" if torch.cuda.is_available() else "cpu")

# デバイス設定
device = "mps" if torch.backends.mps.is_available() else "cpu"

# モデルファイルのパス
PIPELINE_PATH = "/pass/to/chilled_remix_v2.safetensors"
LORA_PATH = "/pass/to/pytorch_lora_weights_SD15.safetensors"

# **Diffusers の初期化**
#pipe = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5", torch_dtype=torch.float16).to(device)
pipe = StableDiffusionPipeline.from_single_file(PIPELINE_PATH, torch_dtype=torch.float16).to(device)
pipe.load_lora_weights(LORA_PATH)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

def generate_selfie(character, scene):
    if scene == "":
        scene_prompt = character_settings[character]['PROMPT_WEAR']
    else:
        scene_prompt = scene

    """キャラの自撮り写真を生成"""
    prompt = f"{character_settings[character]['PROMPT_CHAR']} {scene_prompt}, taking a selfie, looking at camera, realistic, detailed, beautiful lighting"
    image = pipe(prompt, height=512, width=384, num_inference_steps=8, guidance_scale=1.0).images[0]  # **画像生成**

    print("自撮り写真プロンプト:", prompt)

    # 画像保存ディレクトリの作成
    save_dir = "./generated_images"
    os.makedirs(save_dir, exist_ok=True)

    # 画像を保存(Gradio で扱いやすいパスに)
    timestamp = int(time.time())  # **現在のタイムスタンプ**
    image_path = os.path.join(save_dir, f"{character}_selfie_{timestamp}.png")
    image.save(image_path)
    return image_path

def chat_response(user_message, character):
    """Ollama を使用してユーザーのメッセージに対するキャラの返信を生成"""
    global chat_history, character_affection
    now = datetime.now()
    datetime_str = now.strftime("%Y-%m-%d(%a) %H:%M")

    # 好感度アップの条件
    if "好き" in user_message or "かわいい" in user_message:
        character_affection[character] += 1

    # 自撮り写真リクエストの処理
    if "写真を送って" in user_message:
        # Ollama による応答生成
        prompt = f"あなたは{character}(性格:{character_settings[character]["性格"]})という名前のキャラクターです。チャット内容と日時から場所や場面を想像して、{character}の服装や場所を伝える英語の簡潔なメッセージを30語以内で作成してください。(現在の日時:{datetime_str})\n\nユーザー: {user_message}\n{character}: "

        try:
            response = ollama.chat(model="llama3:8b", messages=[{"role": "user", "content": prompt}])
            scene_text = response["message"]["content"].strip()
        except Exception as e:
            scene_text = f"エラーが発生しました: {str(e)}"

        image_path = generate_selfie(character, scene_text)
        chat_history.append((user_message, (image_path,)))  # 画像をタプルで追加
        return chat_history[-10:]

    # Ollama による応答生成
    prompt = f"あなたは{character}(性格:{character_settings[character]["性格"]})という名前のキャラクターです。日時から場所や場面を想像してユーザーとの自然なチャットを日本語で行ってください。生成したメッセージが日本語でない場合は、日本語になるまでメッセージを再生成してください。(現在の日時:{datetime_str})\n\nユーザー: {user_message}\n{character}: "

    try:
        response = ollama.chat(model="llama3:8b", messages=[{"role": "user", "content": prompt}])
        reply_text = response["message"]["content"].strip()
    except Exception as e:
        reply_text = f"エラーが発生しました: {str(e)}"

    print("プロンプト:", prompt)
    print("生成結果:", reply_text)

    chat_history.append((user_message, reply_text))
    return chat_history[-10:]

# Gradio UIの設定
gr_theme = gr.themes.Soft(
    primary_hue="pink",
    secondary_hue="rose",
    neutral_hue="gray",
    font=["Arial", "sans-serif"]
).set(
    body_background_fill="#ffe4e1"  # 全体の背景色(恋愛ゲーム風)
    #body_background_fill_dark="#ffccd5"  # ダークモード時の背景色
)

# Gradio UIの構築
def chat_interface():
    #with gr.Blocks(css=".gradio-container { background-color: #ffe4e1 !important; } .chatbot .user { background-color: #ffccdd !important; } .chatbot .bot { background-color: #ffffff !important; }") as demo:
    with gr.Blocks(theme=gr_theme) as demo:
        gr.Markdown("## 📱 恋愛チャットシミュレーション")

        with gr.Row():
            character_select = gr.Radio(["美咲", "花音", "涼夏"], label="キャラ選択", value="美咲")

        chatbot = gr.Chatbot(label="Chat")
        user_input = gr.Textbox(placeholder="メッセージを入力...", interactive=True)
        send_button = gr.Button("送信")

        def update_chat(user_message, character):
            chat_result = chat_response(user_message, character)
            return chat_result, ""

        user_input.submit(update_chat, [user_input, character_select], [chatbot, user_input], queue=False)
        send_button.click(update_chat, [user_input, character_select], [chatbot, user_input], queue=False)

    return demo

chat_interface().launch(share=True)
6. アプリの実行
準備が整ったら、次のコマンドでアプリを実行します。
python3 chat_app.py
または、仮想環境を有効にしている場合は:
source chat_env/bin/activate
python3 chat_app.py
実行後、http://127.0.0.1:7860/ にアクセスし、チャットを楽しんでください。
「写真を送って」をメッセージに含めると、彼女が自撮り写真を送ってくれます。


7. トラブルシューティング
7.1 Ollama が認識されない
ollama コマンドが見つからない場合、ターミナルを再起動し、ollama list を試してください。
7.2 画像が表示されない
generated_imagesディレクトリが作成されているか確認してください。- Gradio の仕様上、ファイルパスが適切でないとエラーが出るため、アプリ実行フォルダ内に画像を保存するように修正してください。
7.3 Python のパッケージが足りない
エラーメッセージを確認し、不足しているパッケージを pip install <パッケージ名> でインストールしてください。
8. まとめ
これで、Mac ローカルで恋愛チャットアプリを実行する準備が整いました。AIキャラクターとの会話や自撮り写真のやり取りを楽しんでください!
Let's Encryptを利用したWindows IISでの無料HTTPS証明書取得手順
Windows IIS で Let's Encrypt を利用して HTTPS を有効にする手順を説明します。
Let's Encrypt は 無料のSSL証明書 を発行でき、自動更新も可能です。
- 1. 必要なツールの準備
- 2. IIS の HTTPS 設定
- 3. Let's Encrypt 証明書の取得
- 4. HTTPSリダイレクトの設定(オプション)
- 5. 自動更新の設定
- 6. ファイアウォールとポートの確認
- 7. 動作確認
- まとめ
1. 必要なツールの準備
Windows IIS で Let's Encrypt を利用するには、win-acme というツールを使います。
🔹 win-acme のダウンロード
- win-acme 公式サイト にアクセス
- 「Download」から
win-acme.v2.x.x.zipをダウンロード - ダウンロードした ZIP を C:\win-acme などに展開
2. IIS の HTTPS 設定
3. Let's Encrypt 証明書の取得
-
管理者権限で PowerShell または コマンドプロンプト を開く
-
cd C:\win-acmeで win-acme のフォルダに移動 -
以下のコマンドを実行
wacs.exe -
インタラクティブなセットアップが始まるので、順番に選択
N: Create new certificate (simple)を選択- 対象のWebサイト(IISのサイト名)を選択
- 「yes」を選択して証明書を取得
-
証明書が正常に発行されると、IIS に自動で適用される
4. HTTPSリダイレクトの設定(オプション)
HTTP から HTTPS へ自動リダイレクトするには URLリライト を設定します。
方法1: IISの「HTTPリダイレクト」を使う
- IIS マネージャーで Webサイトを選択
- 「HTTP リダイレクト」 を開く
- 「要求をリダイレクトする」にチェックを入れ
https://yourdomain.comを指定 - 「適用」をクリック
方法2: Web.config にリダイレクトルールを追加
C:\inetpub\wwwroot\web.config に以下を追加
<configuration>
    <system.webServer>
        <rewrite>
            <rules>
                <rule name="Redirect to HTTPS" stopProcessing="true">
                    <match url="(.*)" />
                    <conditions>
                        <add input="{HTTPS}" pattern="^OFF$" />
                    </conditions>
                    <action type="Redirect" url="https://{HTTP_HOST}/{R:1}" redirectType="Permanent" />
                </rule>
            </rules>
        </rewrite>
    </system.webServer>
</configuration>
5. 自動更新の設定
Let's Encrypt の証明書は 90日ごとに更新が必要 ですが、win-acme で自動更新できます。
タスクスケジューラを使う
- タスクスケジューラ(taskschd.msc)を開く
- 「基本タスクの作成」で以下を設定
- 名前:
Let's Encrypt 更新 - トリガー:
毎日 - 開始時刻:
午前3時(任意) - 操作:
プログラムの開始 - プログラム/スクリプト:
C:\win-acme\wacs.exe - 引数の追加:
--renew --quiet
- 名前:
- 完了をクリックして保存
6. ファイアウォールとポートの確認
7. 動作確認
ブラウザで https://yourdomain.com にアクセスし、SSL が適用されていることを確認。
証明書の詳細を開き、「Let's Encrypt」と表示されていれば成功! 🎉
まとめ
| ステップ | 手順 |
|---|---|
| 1. win-acme をダウンロード | win-acme をダウンロードして展開 |
| 2. IISのHTTPS設定 | IISでHTTPSバインドを追加 |
| 3. 証明書取得 | wacs.exe を実行して Let's Encrypt 証明書を取得 |
| 4. HTTPSリダイレクト | IISの「HTTPリダイレクト」または Web.config を設定 |
| 5. 自動更新設定 | タスクスケジューラで wacs.exe --renew を実行 |
| 6. ファイアウォール設定 | ポート 443 を開放 |
| 7. 動作確認 | https://yourdomain.com にアクセス |
MacOSローカルで動くシナリオ自動生成の恋愛ゲームを作成しました!
無人島サバイバル恋愛アドベンチャーゲームをMacOSで動作させる手順

はじめに
本記事では、AIを活用してシナリオとシーン画像を自動生成する無人島サバイバル恋愛アドベンチャーゲーム「恋AIらんど -RenAIsland-」を、MacOS上に構築し動作させる手順を紹介します。
このゲームは、ストーリーおよびシーン画像を生成AIを活用して実行時に作成しています。3人の女性キャラクターとの、毎回異なる恋愛ストーリーを楽しめます。
1. 必要な環境の準備
今回使用したマシン
iMac Retina 4K 2017
CPU: Core i5
RAM: 8GB
GPU: Radeon Pro 560 4GB
OS: Ventura 13.6.7
1.1 Pythonのインストール
まずはPythonがインストールされていることを確認します。MacOSにはデフォルトでPythonが含まれていますが、最新バージョンを利用するためにHomebrewを使用してインストールします。
brew install python3
1.2 仮想環境の作成
作業フォルダを作成し、仮想環境を構築します。
mkdir renaisland
cd renaisland
mkdir static
mkdir templates
python3 -m venv venv
source venv/bin/activate
1.3 必要なライブラリのインストール
以下のパッケージをインストールします。
pip install flask torch diffusers pillow1.4 Ollama のセットアップ
シナリオの分岐をAIで作るためにローカルのLLMを使用します。今回は一番手軽なOllamaで動かします。
公式サイト からダウンロード & インストール
日本語でシナリオ作成指示するので、日本語対応のモデルをダウンロードします。
ollama pull gemma:7b
または
ollama pull llama3:8b
使用するLLMに応じてapp.py中の1箇所を変更してください。
        # llama3:8b または gemma:7b
        print("シナリオ生成開始")
        result = subprocess.run(
            ["ollama", "run", "llama3:8b", prompt],
            capture_output=True,
            text=True
        )
1.5 StableDiffusionモデルファイル&LCM Loraダウンロード
お好みのSD1.5モデルファイルを使用できます。
sazyou-roukaku/chilled_remix at main 今回はこちらをお借りしました。
latent-consistency/lcm-lora-sdv1-5 at main LCM Loraダウンロード先

2. ゲームの構築
配置先:
/renaisland/
│── app.py
│── static/  # 画像ファイルを保存するフォルダ
│── templates/
│   └── index.html  # フロントエンド
2.1 バックエンド (app.py)
次の内容で app.py を作成します。
モデルファイルのパスは実行環境に合わせて変更してください。
import re
import os
import time
import subprocess
import json
import random
import torch
from flask import Flask, render_template, request, jsonify, send_from_directory
from diffusers import StableDiffusionPipeline, LCMScheduler
from PIL import Image

app = Flask(__name__)

# モデルファイルのパス
PIPELINE_PATH = "/pass/to/chilled_remix_v2.safetensors"
LORA_PATH = "/pass/to/pytorch_lora_weights_SD15.safetensors"

# デバイス設定
device = "mps" if torch.backends.mps.is_available() else "cpu"

# **Diffusers の初期化**
#pipe = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5", torch_dtype=torch.float16).to(device)
pipe = StableDiffusionPipeline.from_single_file(PIPELINE_PATH, torch_dtype=torch.float16).to(device)
pipe.load_lora_weights(LORA_PATH)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config)

# **シーンカウントの設定**
MAX_SCENES = 8  # **クライマックスに移行する指定回数**
scene_count = 0  # **現在のシーン数**
MAX_RETRIES = 5  # **シナリオ生成最大リトライ回数**

# 人物設定
person = {
    "美咲": {"性格": "美人で優しい女性。面倒見が良く、癒し系。",
           "PROMPT": "a Japanese beauty woman in a fitted white long sleeves ribbed top and a grey plaid suspenders overalls Dress, Light brown Long hair (wavey, glamorous style). "},
    "花音": {"性格": "可愛くて明るいムードメーカー。元気いっぱいで好奇心旺盛。",
           "PROMPT": "a kawaii woman in a white collared shirt, a red plaid pleated skirt, a plaid bow, a soft pink cardigan , knee-high white socks, loose curls twin tails Semi-long Pink Hair. "},
    "涼子": {"性格": "クールでツンデレ。素直になれないが、時折見せる優しさが魅力。",
           "PROMPT": "a Japanese idol woman in a cream long hoodie, Short bob Hair. "}
}
heroine = ""  #選択した女性(美咲,花音,涼子)

def generate_image(scene_text, scene_name, image_prompt):
    """Diffusers を使って画像を生成し、保存する"""
    image_path = f"static/{scene_name}.png"

    # **既存の画像があれば削除**
    if os.path.exists(image_path):
        os.remove(image_path)

    person_prompt = ""

    if "女性" in scene_text or "彼女" in scene_text:
        person_prompt = "(solo shot), Silhouette of a woman, "

    if "美咲" in scene_text:
        person_prompt = "(solo shot), " + person["美咲"]["PROMPT"]

    if "花音" in scene_text:
        person_prompt = "(solo shot), " + person["花音"]["PROMPT"]

    if "涼子" in scene_text:
        person_prompt = "(solo shot), " + person["涼子"]["PROMPT"]

    prompt = f"(SFW), realistic, {person_prompt}{image_prompt}, highly detailed."
    image = pipe(prompt, height=512, width=512, num_inference_steps=8, guidance_scale=1.0).images[0]  # **画像生成**
    image.save(image_path)  # **画像を保存**

    timestamp = int(time.time())  # **現在のタイムスタンプ**

    return f"{image_path}?t={timestamp}"  # **キャッシュを防ぐURLを返す**

# **最初のシナリオ**
story = {}
def static_story():
    global story

    start_text = f"""飛行機は突如エンジントラブルに見舞われ、見知らぬ海へと墜落した。奇跡的に生き残ったあなたは、無人島に漂着し、砂浜にもう一人の生存した女性を見つけた。
    その女性はー"""
    start_image_prompt = "A deserted tropical island beach with a crashed airplane. The wreckage is partially buried in the sand, surrounded by palm trees and ocean waves."
    start_image = generate_image(start_text, "start", start_image_prompt)  # **最初の画像を生成**

    story = {
        "start": {
            "text": start_text,
            "choices": {
                "美咲": "美咲",
                "花音": "花音",
                "涼子": "涼子"
            },
            "image_prompt": start_image_prompt,
            "image": start_image  # **生成した画像のパスを設定**
        }
    }
    return

static_story()

# **JSON の中から `text` の値を抽出し、改行のみをエスケープ**
def fix_json_string(json_text):
    match = re.search(r'("text":\s*")(.*?)(")', json_text, re.DOTALL)
    if match:
        fixed_text = match.group(2).replace("\n", "\\n")  # 改行のみエスケープ
        json_text = json_text[:match.start(2)] + fixed_text + json_text[match.end(2):]

    return json_text

def generate_story(scene, scene_name, pre_text):
    global scene_count
    scene_count += 1  # **シーン数を増やす**
    ending = ""

    if scene_name == "happy_end":
        ending = "ハッピーエンド"
    elif scene_name == "bad_end":
        ending = "バッドエンド"
    elif scene_name == "":
        scene_name = scene

    """シナリオを生成し、画像も生成する"""
    for attempt in range(MAX_RETRIES):  # **リトライ**
        # クライマックス前
        if scene_count == MAX_SCENES:
            prompt = f"""
            飛行機事故により無人島に漂着したプレイヤーと{heroine}の、サバイバルと恋愛を描くノベルゲームの、前回のストーリーに対するプレイヤーの選択の次の場面の「重大なことが起こるシーン」ストーリーを日本語で作成してください。(5文以内で)
            無人島でのサバイバル要素や、恋愛要素などを盛り込んでください。
            そして、そのシーンの背景画像を生成するためのプロンプトを英語で作成してください。(簡潔に)
            また、プレイヤーに提示する選択肢を2つ日本語で考えてください。

            前回のストーリー:{pre_text}
            プレイヤーの選択:{scene}
            {heroine}の性格:{person[heroine]["性格"]}

            出力フォーマット:
            ```
            {{"text": "ここに重大なことが起こるシーンのストーリー",
            "image_prompt": "ここに背景画像を生成するためのプロンプト",
            "choices": {{"scene_{scene_count}-1": "ここに選択肢1のテキスト", "scene_{scene_count}-2": "ここに選択肢2のテキスト"}}}}
            ```
            """

        elif scene_count > MAX_SCENES:
            # **クライマックスとエンディングの判定**
            if ending == "ハッピーエンド" or ending == "バッドエンド":
                prompt = f"""
                飛行機事故により無人島に漂着したプレイヤーと{heroine}の、サバイバルと恋愛を描くノベルゲームの、前回のストーリーに対するプレイヤーの選択の次の場面の「{ending}シーン」ストーリーを日本語で作成してください。(5文以内で)
                無人島でのサバイバル要素や、恋愛要素などを盛り込んでください。
                そして、そのシーンの背景画像を生成するためのプロンプトを英語で作成してください。(簡潔に)

                前回のストーリー:{pre_text}
                プレイヤーの選択:{scene}
                {heroine}の性格:{person[heroine]["性格"]}

                出力フォーマット:
                ```
                {{"text": "ここに最終話のストーリー",
                "image_prompt": "ここに背景画像を生成するためのプロンプト",
                "choices": {{"restart": "最初から"}}}}
                ```
                """

            else:
                prompt = f"""
                飛行機事故により無人島に漂着したプレイヤーと{heroine}の、サバイバルと恋愛を描くノベルゲームの、前回のストーリーに対するプレイヤーの選択の次の場面の「クライマックスシーン」ストーリーを日本語で作成してください。(5文以内で)
                無人島でのサバイバル要素や、恋愛要素などを盛り込んでください。
                そして、そのシーンの背景画像を生成するためのプロンプトを英語で作成してください。(簡潔に)
                また、プレイヤーに提示するハッピーエンドとバッドエンドに展開する選択肢を日本語で考えてください。

                前回のストーリー:{pre_text}
                プレイヤーの選択:{scene}
                {heroine}の性格:{person[heroine]["性格"]}

                出力フォーマット:
                ```
                {{"text": "ここにクライマックスシーンのストーリー",
                "image_prompt": "ここに背景画像を生成するためのプロンプト",
                "choices": {{"happy_end": "ここにハッピーエンドに展開する選択肢", "bad_end": "ここにバッドエンドに展開する選択肢"}}}}
                ```
                """

        else:
            """通常のシナリオ生成(クライマックスでない場合)"""
            prompt = f"""
            飛行機事故により無人島に漂着したプレイヤーと{heroine}の、サバイバルと恋愛を描くノベルゲームの、前回のストーリーに対するプレイヤーの選択の次の場面のストーリーを日本語で作成してください。(5文以内で)
            無人島でのサバイバル要素や、恋愛要素などを盛り込んでください。
            そして、そのシーンの背景画像を生成するためのプロンプトを英語で作成してください。(簡潔に)
            また、プレイヤーに提示する選択肢を2つ日本語で考えてください。

            前回のストーリー:{pre_text}
            プレイヤーの選択:{scene}
            {heroine}の性格:{person[heroine]["性格"]}

            出力フォーマット:
            ```
            {{"text": "ここに次の場面のストーリー",
            "image_prompt": "ここに背景画像を生成するためのプロンプト",
            "choices": {{"scene_{scene_count}-1": "ここに選択肢1のテキスト", "scene_{scene_count}-2": "ここに選択肢2のテキスト"}}}}
            ```
            """

        # llama3:8b または gemma:7b
        print("シナリオ生成開始")
        print(f"プロンプト(試行 {attempt + 1} 回目):", prompt)
        result = subprocess.run(
            ["ollama", "run", "llama3:8b", prompt],
            capture_output=True,
            text=True
        )

        text = result.stdout.strip()
        print(f"生成結果(試行 {attempt + 1} 回目):", text)  # デバッグ用

        # **JSON 部分を正しく抽出**
        match = re.search(r"```(?:json)?\n(.*?)\n```", text, re.DOTALL)
        json_text = match.group(1).strip() if match else text.strip()

        # **余分な `}` を削除**
        while json_text.count("{") < json_text.count("}"):
            json_text = json_text.rsplit("}", 1)[0]  # 最後の `}` を削除

        # **全角「」の前後に抜けた"を追加**
        json_text = json_text.replace(': 「', ': "「').replace(':「', ': "「')  # 「の前の"もれ
        json_text = json_text.replace('」,', '」",').replace('」 }', '」" }').replace('」}', '」"}')  # 」の後の"もれ
        json_text = json_text.replace('」\n}', '」"\n}')  # 」と\n}の間の"もれ
        json_text = json_text.replace('」",\n}', '」"\n}')  # 」",\n}の,削除

        # **「"""」を「"」にする**
        json_text = json_text.replace('"""', '"')

        # **「プレイヤー」を「あなた」にする**
        json_text = json_text.replace('プレイヤー', 'あなた')

        # **カンマ抜けの修正**
        json_text = re.sub(r'("text": "[^"]+)"\s+"image_prompt"', r'\1, "image_prompt"', json_text)
        json_text = re.sub(r'("image_prompt": "[^"]+)"\s+"choices"', r'\1, "choices"', json_text)

        # **': ""文字列",' を ': "文字列",' となるように正規表現による置換**
        json_text = re.sub(r':\s*""(.*?)"', r': "\1"', json_text)

        # **改行をエスケープ**
        json_text = fix_json_string(json_text)

        print("修正後の生成結果:", json_text)  # デバッグ用

        # **JSONとしてパース**
        try:
            story_data = json.loads(json_text)

            # **"choices" のKeyとValueを入れ替え(llama3:8bのイタズラ回避策)**
            if "choices" in story_data:
                new_choices = {value: key for key, value in story_data["choices"].items()}
                story_data["choices"] = new_choices

            if ending != "":
                story_data["text"] += "\n- 終わり -"

            # **画像を生成**
            #scene_name = f"scene_{len(story)}"
            image_path = generate_image(story_data["text"], scene_name, story_data["image_prompt"])
            story_data["image"] = image_path

            return story_data

        except json.JSONDecodeError as e:
            print("JSONDecodeError:", e)  # デバッグ用

    # **MAX_RETRIES 回試しても失敗した場合**
    return {"text": "シナリオの生成に失敗しました。再読み込みしてください。", "choices": {"最初から": "restart"}, "image": "static/error.png"}

# JSONファイルに保存(何かに利用したい時のために)
def save_to_json(data, filename="story.json"):
    with open(filename, "w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=4)

@app.route('/')
def index():
    return render_template('index.html')

@app.route('/story', methods=['POST'])
def get_story():
    data = request.json
    scene = data.get("scene", "start")
    global heroine
    global scene_count, story

    # keyに選択肢のテキストが入っている
    # 選択肢のストーリーtextも取得
    value_to_find = scene
    key = scene  # 見つからなかった時はscene使う
    pre_text = ""
    for k1,v1 in story.items():
        t = v1["text"]
        for k,v in v1["choices"].items():
            if v == value_to_find:
                key = k
                pre_text = t
                break

    if scene == "美咲" or scene == "花音" or scene == "涼子":
        heroine = key
        generate_image(heroine, "error", "Error screen for a visual novel game. Dark background with glitch effects.")  # **エラー画像を生成**

    if scene == "restart":
        # **ゲームをリセット**
        scene_count = 0
        story = {}
        static_story()
        save_to_json(story)
        return jsonify(story["start"])

    if scene in story:
        return jsonify(story[scene])

    # **AIで新しいシナリオを生成**
    generated_story = generate_story(key, scene, pre_text)  # keyに選択肢のテキストが入っている
    story[scene] = generated_story  # **新しいストーリーを保存**
    save_to_json(story)

    return jsonify(generated_story)

@app.route('/static/')
def get_image(filename):
    return send_from_directory("static", filename)

if __name__ == '__main__':
    app.run(host="0.0.0.0", port=5000, debug=True)
2.2 フロントエンド (index.html)
次に、templates/index.html を作成します。
<!DOCTYPE html>
<html lang="ja">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>恋AIらんど -RenAIsland-</title>
    <style>
        body {
            font-family: 'Arial', 'cursive', sans-serif;
            background: linear-gradient(to bottom, #ffcccc, #ff99cc);
            color: #333;
            text-align: center;
            padding: 20px;
        }
        #game-container {
            max-width: 600px;
            margin: auto;
            background: rgba(255, 255, 255, 0.8);
            padding: 20px;
            border-radius: 15px;
            box-shadow: 0 0 15px rgba(255, 105, 180, 0.5);
            position: relative;
        }
        #story-image {
            width: 100%;
            height: auto;
            border-radius: 10px;
        }
        #character-image {
            position: absolute;
            bottom: 10px;
            right: 10px;
            width: 180px;
            height: auto;
        }
        #story-text {
            background: rgba(255, 255, 255, 0.9);
            padding: 15px;
            border-radius: 10px;
            font-size: 18px;
            margin-top: 10px;
        }
        .choice-btn {
            display: block;
            width: 80%;
            max-width: 500px;
            padding: 12px;
            margin: 8px auto;
            background-color: #ff6699;
            color: white;
            border: none;
            border-radius: 20px;
            cursor: pointer;
            font-size: 18px;
            transition: 0.3s;
        }
        .choice-btn:hover {
            background-color: #cc3366;
        }
    </style>
</head>
<body>
    <h1>恋AIらんど -RenAIsland-</h1>
    <div id="game-container">
        <img id="story-image" src="static/start.png" alt="シーン画像">
        <img id="character-image" src="" alt="キャラ画像" style="display: none;">
        <p id="story-text">ロード中...</p>
        <div id="choices"></div>
    </div>

    <script>
        let currentScene = "start";

        function loadStory(scene) {
            fetch("/story", {
                method: "POST",
                headers: { "Content-Type": "application/json" },
                body: JSON.stringify({ scene: scene })
            })
            .then(response => response.json())
            .then(data => {
                document.getElementById("story-text").innerText = data.text;
                document.getElementById("story-image").src = data.image;

                // キャラクター画像があれば表示
                let charImage = document.getElementById("character-image");
                if (data.character_image) {
                    charImage.src = data.character_image;
                    charImage.style.display = "block";
                } else {
                    charImage.style.display = "none";
                }

                let choicesContainer = document.getElementById("choices");
                choicesContainer.innerHTML = "";

                for (let choice in data.choices) {
                    let button = document.createElement("button");
                    button.innerText = choice;
                    button.className = "choice-btn";
                    button.onclick = () => loadStory(data.choices[choice]);
                    choicesContainer.appendChild(button);
                }
            })
            .catch(error => console.error("エラー:", error));
        }

        window.onload = () => loadStory(currentScene);
    </script>
</body>
</html>
3. ゲームの実行
以下のコマンドでFlaskサーバーを起動します。
cd renaisland
source venv/bin/activate
python app.py
ブラウザで http://127.0.0.1:5000/ にアクセスするとゲームが表示されます。

実行するマシンによって、選択肢をクリックした後の応答に時間を要します。イライラして何度もクリックしないようにご注意ください。
ターミナルにデバッグ用のAI生成テキストが出力されるので気づくと思いますが、生成結果が出力フォーマットを守られていないことがあります。そのため、フォーマットエラー時は再生成をします。再生成を指定回数行ってもエラーの時はシナリオ作成エラーと表示します。

まとめ
本記事では、無人島サバイバル恋愛アドベンチャーゲームをMacOS上に構築し、動作させるまでの手順を紹介しました。AIを活用したストーリーと画像生成を組み合わせ、動的なゲーム体験を実現できます。
Windows 10 で詳細な起動情報を表示する方法
Windows 10 で詳細な起動情報を表示する方法
Windows 10 では、Linux のような「verbose(冗長)」な起動モードは標準では用意されていませんが、いくつかの方法で詳細な起動情報を取得することができます。本記事では、起動時の詳細情報を表示・記録する方法を紹介します。
1. OSブート情報を有効にする
Windows の起動時にドライバのロード状況などを画面に表示する方法です。
設定手順
- [Win] + [R] を押し、「msconfig」と入力して Enter。
- 「ブート」タブを開く。
- 「詳細オプション」をクリックし、「OSブート情報」にチェックを入れる。
- 「適用」→「OK」をクリックし、再起動。
再起動時に、ドライバの読み込み状況がテキストで表示されるようになります。
2. イベントビューアで起動ログを確認
確認手順
- [Win] + [X] を押して「イベントビューア」を開く。
- 「Windows ログ」→「システム」を開く。
- 「イベントID 100~199」のイベントをフィルタリング。
- 起動関連のエラーや詳細情報を確認。
特に イベントID 100(起動時間) や イベントID 101(ブートプロセス詳細) に注目するとよいでしょう。
3. bootlog(ブートログ)を有効にする
設定手順
- 管理者権限で コマンドプロンプト を開く。
- 以下のコマンドを実行:
bcdedit /set {current} bootlog Yes - 再起動。
C:\Windows\ntbtlog.txtにログが記録される。
この ntbtlog.txt を開くと、起動時にロードされたドライバの一覧を確認できます。
4. セーフモードで詳細な情報を確認
設定手順
- [Shift] を押しながら [再起動] をクリック。
- 「トラブルシューティング」→「詳細オプション」→「スタートアップ設定」→「再起動」。
- 再起動後、
F8を押して「セーフモード(またはログ記録付き)」を選択。
これにより、起動時に読み込まれるドライバやエラー情報が画面に表示されます。
5. デバッグモードを有効にする
設定手順
デバッグモードは開発者向けの機能ですが、起動時の問題を解析するのに役立つ場合があります。
まとめ
Windows 10 で起動時の詳細な情報を取得する方法はいくつかあります。
| 方法 | 特徴 |
|---|---|
| OSブート情報の表示 | 起動時のドライバ読み込み状況を画面に表示 |
| イベントビューア | 起動ログを後から確認可能 |
| bootlog 記録 | ntbtlog.txt にドライバ情報を記録 |
| セーフモード | システムメッセージがより多く表示される |
| デバッグモード | 詳細なデバッグ情報を取得 |
起動のトラブルシューティングを行う際は、これらの方法を試してみてください。
